
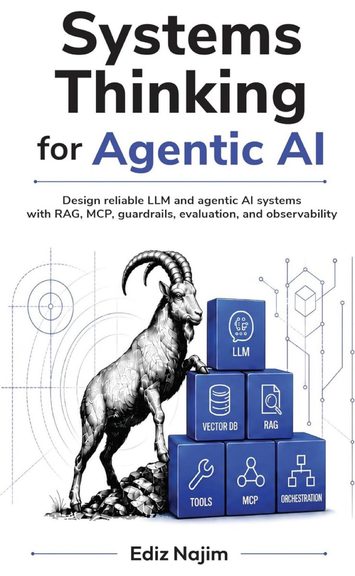
Системное мышление для агентного ИИ предполагает, что надёжность обеспечивается не выбором одной лучшей модели, а продуманным взаимодействием всех слоёв — от LLM и RAG до оркестрации и инструментов.
Книга Эдиза Наджима выделяет девять ключевых составляющих, включая защитные ограждения, оценку качества и наблюдаемость, и даёт практический подход к переходу от прототипов к production-системам.
Эти элементы вместе образуют современную архитектуру агентных систем, где модель перестаёт быть изолированным «чёрным ящиком» и становится частью управляемой, проверяемой и безопасной экосистемы.
Контекст
В 2024–2026 годах произошёл переход от простых чат-ботов к агентным системам. Агенты не просто генерируют текст, а планируют действия, вызывают инструменты, работают с внешними данными и могут выполнять многошаговые задачи. Это резко повышает полезность, но одновременно увеличивает риски: галлюцинации, утечки данных, непредсказуемое поведение, высокие затраты и сложность отладки.
Системное мышление здесь означает, что надёжность достигается не за счёт одной «лучшей» модели, а за счёт правильно организованного взаимодействия всех слоёв. LLM даёт интеллект, Vector DB и RAG — актуальные знания, Tools и MCP — доступ к внешнему миру, Orchestration — управление сложными процессами, а guardrails, evaluation и observability обеспечивают безопасность, качество и прозрачность.
Составляющие и особенности
1. LLM (Large Language Model)
Ядро системы. Современные модели 2026 года демонстрируют сильные результаты в рассуждении, кодировании и работе с агентами.
Популярные примеры:
- Открытые/доступные варианты: семейства DeepSeek, Qwen, GLM, Kimi и другие.
- Claude Opus 5.5 и семейство Claude Fable 5.x (Anthropic) — часто лидируют в агентных и сложных задачах.
- GPT-6.1 Sol и GPT-6 Astra (OpenAI) — сильные в общем интеллекте и инструментах.
- Gemini 4 Argon и Gemini 3.x (Google) — хороши в мультимодальности и цене.
Особенность: выбор модели всё чаще зависит не только от бенчмарков, но и от стоимости, latency, поддержки tool-calling и контекстного окна (часто 1M+ токенов).
2. Vector DB (векторные базы данных)
Хранилище эмбеддингов документов, необходимое для семантического поиска.
Популярные решения 2026 года:
- Pinecone — полностью управляемый сервис, удобен для быстрого запуска.
- Qdrant и Weaviate — мощные open-source варианты с отличной фильтрацией и hybrid search.
- Milvus / Zilliz — масштабирование до миллиардов векторов.
- pgvector — когда уже есть PostgreSQL.
- Chroma и LanceDB — для прототипирования и локальной разработки.
Особенность: важны hybrid search (векторы + ключевые слова), фильтрация по метаданным и поддержка multi-tenancy.
3. RAG (Retrieval-Augmented Generation)
Архитектура, которая подтягивает релевантный контекст из Vector DB перед генерацией ответа. Это основной способ снизить галлюцинации и работать с актуальными/приватными данными.
Популярные фреймворки:
- LlamaIndex — сильный в загрузке, парсинге и индексации документов.
- LangChain + LangGraph — гибкость и агентные сценарии.
- Haystack — явные, прозрачные пайплайны с встроенной оценкой.
- RAGFlow, DSPy, LightRAG и GraphRAG-подходы — для более сложных или специализированных задач.
Особенность: качество RAG сильно зависит от chunking, embedding-моделей, reranking и оценки retrieval-качества.
4. Tools (инструменты)
Функции, которые агент может вызывать: поиск, API, калькуляторы, браузеры, работа с файлами и т.д. Без инструментов агент остаётся «говорящей головой».
Примеры базовых инструментов агентного харнесса
Харнесс (harness) — среда вокруг модели, которая организует цикл работы агента, предоставляет инструменты и управляет контекстом и разрешениями. Для понимания этого слоя полезнее начать не с внешних сервисов, а с базовых операций, представленных в Claude Code, OpenCode, OpenClaw и экосистеме LangChain.
Ниже — практическая десятка по роли в работе агента, а не статистический рейтинг вызовов. Названия, доступность и права зависят от версии, платформы и конфигурации. LangChain — конструктор агентов, а не готовый харнесс с единым набором инструментов; для сравнения со встроенным окружением здесь используется Deep Agents из его экосистемы.
| Инструмент / операция | Для чего нужен | Примеры в харнессах | Типовая задача |
| Read — чтение файлов | Получать код, документы и конфигурацию, в том числе по диапазону строк | Claude Code: `Read`; OpenCode / OpenClaw: `read`; Deep Agents: `read_file` | Прочитать конфигурацию перед изменением |
| Edit / Apply patch — точечная правка | Изменять конкретные фрагменты, не перезаписывая весь файл | Claude Code: `Edit`; OpenCode / OpenClaw: `edit`, `apply_patch`; Deep Agents: `edit_file` | Исправить функцию или применить патч |
| Bash / Exec — выполнение команд | Запускать тесты, сборку, CLI и скрипты | Claude Code: `Bash`; OpenCode: `bash`; OpenClaw: `exec`; Deep Agents: `execute` при sandbox-бэкенде | Выполнить тесты, посмотреть `git diff`, обработать данные |
| Write — создание файлов | Сохранять новые документы, код и результаты | Claude Code: `Write`; OpenCode / OpenClaw: `write`; Deep Agents: `write_file` | Создать тест, отчёт или новый модуль |
| Glob / List — поиск файлов и обзор каталогов | Находить файлы по имени, маске или расположению | OpenCode / Deep Agents: `glob`; Deep Agents: `ls`; Claude Code: `Glob` либо поиск через `Bash`; OpenClaw: команды через `exec` | Найти конфигурации или все файлы тестов |
| Grep — поиск по содержимому | Находить символы, сообщения ошибок и фрагменты текста | OpenCode / Deep Agents: `grep`; Claude Code: `Grep` либо поиск через `Bash`; OpenClaw: команды через `exec` | Найти все использования функции |
| Web fetch — чтение страницы по URL | Получать содержимое известной веб-страницы без управления браузером | Claude Code: `WebFetch`; OpenCode: `webfetch`; OpenClaw: `web_fetch`; в Deep Agents подключается отдельно | Прочитать документацию API |
| Web search — поиск в интернете | Находить актуальные источники, ссылки и примеры | Claude Code: `WebSearch`; OpenCode: `websearch` при поддерживаемой конфигурации; OpenClaw: `web_search`; в LangChain / Deep Agents — подключаемый инструмент | Найти актуальную инструкцию или решение ошибки |
| Subagent / Delegate — делегирование | Передавать отдельную задачу агенту с собственным контекстом | Claude Code: `Agent`; OpenClaw: `sessions_spawn`, `subagents`; Deep Agents: встроенная поддержка субагентов | Отдельно исследовать часть кодовой базы и вернуть выводы |
| Ask user / Human approval — участие человека | Уточнять требования или приостанавливать чувствительное действие до решения пользователя | Claude Code: `AskUserQuestion`; OpenCode: `question`; OpenClaw: `ask_user`; Deep Agents: human-in-the-loop через `interrupt_on` | Уточнить неоднозначное требование или согласовать запись данных |
Важные различия: отдельный инструмент и возможность выполнить ту же операцию через shell — не одно и то же. Например, в актуальной документации Claude Code Glob и Grep по умолчанию отсутствуют на macOS, Linux и WSL: поиск выполняется через Bash. В OpenCode доступность websearch зависит от провайдера или настроек. В Deep Agents shell-инструмент execute требует sandbox-бэкенда. Уточняющий вопрос пользователю также не заменяет механизм авторизации: подтверждение выполнения должно обеспечиваться политикой среды.
Особенность: надёжность зависит не от количества инструментов, а от их контрактов и ограничений: разрешённых каталогов, прав доступа, таймаутов, лимитов вывода и подтверждения опасных действий. Доступ к shell особенно чувствителен: ограничения отдельных файловых инструментов сами по себе не ограничивают команды терминала.
Примеры внешних инструментов
Внешние инструменты расширяют базовые возможности харнесса: дают доступ к специализированному поиску, браузерной инфраструктуре, репозиториям, базам данных и бизнес-системам. Их подключают через API, SDK, MCP или собственные функции-обёртки. «Внешний» не обязательно означает облачный: сервис или MCP-сервер может работать локально, но подключаться отдельно от основного харнесса.
| Инструмент | Что добавляет | Пример задачи |
| **Tavily** | Веб-поиск и извлечение контента для ИИ-приложений | Найти актуальные источники и собрать материалы для исследования |
| **Exa** | Поиск веб-материалов и получение содержимого по URL | Подобрать документацию, статьи и примеры по заданной теме |
| **Firecrawl** | Обход сайтов, скрейпинг, преобразование страниц в Markdown и структурированные данные | Подготовить документацию сайта для базы знаний |
| **Playwright MCP** | Управление браузером через инструменты навигации и взаимодействия со страницей | Проверить интерфейс, заполнить форму, пройти пользовательский сценарий |
| **Browserbase / Stagehand** | Облачные браузерные сессии и средства автоматизации действий | Выполнить многошаговую задачу в веб-приложении |
| **GitHub MCP Server** | Доступ к коду, issues, pull requests и GitHub Actions | Создать задачу, изучить изменения, проверить результаты CI |
| **SQLDatabaseToolkit** | Инструменты просмотра схемы, проверки и выполнения SQL-запросов | Получить ответ по данным в реляционной базе |
Дополнительно агенту можно предоставить узкие инструменты поверх API почты, календаря, CRM, CMS или мессенджера: например, get_order_status, create_ticket или save_draft. Это примеры прикладных функций, а не универсальные названия готовых инструментов.
Граница между слоями: web_search — операция, которую видит модель, а Tavily или Exa могут быть её реализацией. Аналогично браузер может быть встроен в харнесс, как в OpenClaw, либо подключаться отдельно через Playwright или облачный сервис. Не каждый харнесс поддерживает любой из этих вариантов без дополнительного адаптера.
Особенность: права внешнего инструмента должны соответствовать конкретной задаче. Для аналитики SQL предпочтителен доступ только на чтение, для GitHub — только необходимые репозитории и операции. Отправку сообщений, публикацию, изменение данных и другие действия с внешними последствиями следует отделять от чтения и защищать проверками и подтверждениями.
5. MCP (Model Context Protocol)
Открытый стандарт (изначально от Anthropic, сейчас под Linux Foundation / Agentic AI Foundation), который стандартизирует подключение инструментов, ресурсов и промптов к AI-приложениям. Часто называют «USB-C для ИИ».
Вместо сотен кастомных интеграций агент подключается к MCP-серверам, которые единообразно описывают доступные возможности. Поддерживается многими клиентами (Claude, Cursor, VS Code, ChatGPT и др.).
Особенность: резко снижает стоимость поддержки интеграций и упрощает масштабирование агентных систем.
6. Orchestration (оркестрация)
Управление многошаговыми и многоагентными процессами: планирование, передача задач, состояние, циклы, human-in-the-loop.
Примеры платформ и фреймворков для агентных процессов:
- Langfuse — наблюдаемость и оценка: трассировка вызовов модели и инструментов, управление промптами, контроль качества, стоимости и задержек. Не оркестратор, а дополняющий его слой мониторинга и улучшения системы.
- n8n — визуальная low-code платформа для workflows: интеграции с внешними сервисами, ИИ-агенты, ветвления и согласование действий человеком.
- LangChain & LangGraph — взаимодополняющие инструменты: LangChain предоставляет компоненты и интеграции для LLM-приложений, а LangGraph — графовую оркестрацию с состоянием, checkpoints и паузами для участия человека.
- CrewAI — ролевые команды агентов.
- Microsoft Agent Framework, OpenAI Agents SDK, Google ADK, Pydantic AI, Mastra — в зависимости от стека и требований к надёжности.
Особенность: для production критичны durable execution, возможность паузы/возобновления и прозрачность потока выполнения.
7. Guardrails (ограждения)
Защитные механизмы на входе, выходе и при вызове инструментов: фильтрация токсичности, PII, prompt injection, соблюдение политик, валидация структуры ответа.
Популярные инструменты:
- NVIDIA NeMo Guardrails — программируемые rails.
- Guardrails AI — валидаторы и схемы.
- LLM Guard, Lakera Guard, облачные решения (AWS Bedrock Guardrails, Azure AI Content Safety).
8. Evaluation (оценка)
Систематическая проверка качества retrieval, генерации и агентного поведения. Без неё невозможно надёжно улучшать систему. Используются метрики релевантности и обоснованности ответа, проверки вызовов инструментов, LLM-as-a-judge, экспертная оценка человеком и регулярные проверки качества при изменениях и в production.
Примеры инструментов оценки
- Langfuse — объединяет трассировки, датасеты, эксперименты и оценку: LLM-as-a-judge, программные проверки и человеческую разметку. Пример: собрать неудачные обращения из production и проверить на них новую версию промпта перед выпуском.
- Ragas — библиотека метрик для RAG и агентов: Context Precision, Context Recall, Faithfulness, Tool Call Accuracy и Agent Goal Accuracy. Пример: проверить, находит ли поиск нужные документы и подтверждается ли ответ извлечённым контекстом. Ragas — инструмент оценки, а не отдельная метрика.
- DeepEval — тестирование LLM-приложений и агентов с интеграцией в pytest и CI/CD; позволяет оценивать выбор инструментов, аргументы вызовов и траекторию выполнения. Пример: при каждом pull request проверять, что агент вызывает нужный инструмент с корректными параметрами.
- promptfoo — CLI и библиотека для сравнения промптов, моделей и приложений на заданных тест-кейсах, с автоматическими проверками и запуском в CI/CD; также поддерживает red teaming. Пример: сравнить несколько моделей на одном наборе вопросов и выявить регрессии качества или нарушения формата ответа.
- LangSmith Evaluation — датасеты, оценщики и сравнение экспериментов; поддерживает offline-оценку перед релизом и online-оценку production-трассировок. Пример: сравнить версии агента на фиксированном датасете, а затем пополнять его реальными ошибками пользователей.
Особенность: проверять нужно не только финальный текст, но и действия агента: выбор инструментов, корректность аргументов, соблюдение ограничений и достижение цели. Оценку LLM-судьи полезно сверять с человеческой разметкой; успешная проверка формата сама по себе не доказывает фактическую правильность ответа.
9. Observability (наблюдаемость)
Трассировка запросов, стоимость токенов, latency, ошибки, поведение агентов.
Примеры платформ наблюдаемости
- Langfuse — приложение передаёт события через SDK или OpenTelemetry-инструментацию, а платформа собирает их в иерархическую трассировку: запрос пользователя → вызов модели → поиск → инструмент → ответ. В интерфейсе можно просмотреть входы и выходы шагов, расход токенов, стоимость и задержки. Например, определить, какой инструмент замедлил ответ и на каком шаге выросли затраты.
- Arize Phoenix — платформа с открытым исходным кодом, которая принимает трассировки по OpenTelemetry / OTLP и использует OpenInference-инструментацию для записи LLM-вызовов, retrieval и инструментов. Выполнение отображается как дерево шагов с их данными и длительностью. Например, при неверном ответе RAG-агента можно проверить, какие документы были извлечены и что передано модели.
- LangSmith — подключается через интеграции с фреймворками или SDK и записывает отдельные вызовы в связанные трассировки агента. Позволяет исследовать ошибки и производительность, а реальные неудачные запуски переносить в датасеты для последующей оценки. Например, найти цепочку вызовов, которая привела к ошибке, и превратить её в регрессионный тест; использование не ограничено LangChain.
- Helicone — один из способов подключения — направить вызовы моделей через AI Gateway: шлюз автоматически регистрирует LLM-запросы и ответы и предоставляет данные для наблюдения за ними. Например, после смены модели проверить задержки, ошибки и затраты. Этот подход прежде всего показывает слой обращений к моделям; полную картину retrieval, инструментов и бизнес-логики нужно инструментировать дополнительно.
Как это устроено: трассировка (trace) объединяет один запуск, а отдельные операции внутри него записываются как spans. OpenTelemetry помогает передавать такие данные в совместимые системы, но способ подключения зависит от платформы: SDK, автоинструментация или шлюз. Перед записью входов и выходов важно маскировать секреты и персональные данные.
Выводы
На обложке книги визуально показана пирамида из блоков, где LLM стоит на вершине, а снизу — инфраструктура (Tools, MCP, Orchestration, Vector DB, RAG). Это точное отражение реальности 2026 года: интеллект модели бесполезен без надёжного доступа к данным, инструментам и управления.
Системное мышление здесь означает, что все компоненты должны проектироваться вместе. Хороший RAG без evaluation быстро деградирует. Мощная оркестрация без guardrails и observability превращается в источник инцидентов. MCP снижает хаос интеграций, но не заменяет безопасность и мониторинг.
Практический вывод для команд: начинайте с чёткого разделения ответственности слоёв, выбирайте инструменты с учётом масштаба и требований к управлению (self-hosted vs managed), и с самого начала закладывайте evaluation + observability. Именно такой подход позволяет перейти от демо-агентов к production-системам, которым можно доверять.